B002 数据文件夹乱得像迷宫?10条科研数据管理法则助你高效科研
来源:公众号 PSY-Brain_Frontier | 发布:2025-12-16 | 原文链接
PsyBrain 脑心前沿 | 公众号 PSY-Brain_Frontier
一键关注,点亮星标 ⭐️
不错过每日前沿资讯
认知神经科学前沿文献分享
研究背景
你是否经历过这样的绝望:几个月前采集的核磁数据,现在却死活想不起被试的编号逻辑;写论文急需某个分析结果,翻遍了文件夹只找到一堆命名为“新建文件夹”的迷宫;好不容易翻出了数据,却发现格式打不开,或者备份硬盘突然损坏……
在认知神经科学和心理学研究中,我们每天都在处理海量的行为数据、影像文件和问卷结果。数据管理(Research Data Management, RDM)不仅仅是整理文件,更是科研可重复性和学术规范的基石。
近日,发表在 《PLoS Computational Biology》 上的一篇新文章 “Ten simple rules for effective research data management”,为我们总结了从项目启动到数据归档的10条黄金法则。无论你是刚进实验室的本科生,还是带领团队的PI,这篇指南都能救你于“数据混乱”的水火之中。
核心建议
法则 1:不仅要埋头实验,更要抬头看“规则”
很多同学在项目开始前,只关注实验设计,却忽略了适用的政策。事实上,国家、资助机构(如NSF, DFG)、专业协会甚至所在的实验室,都可能有具体的数据政策 。因此在项目启动阶段,就去查阅资助方官网或学校科研处的要求,尽早绘制数据发布场景图(例如:哪些数据必须公开,哪些必须保密),以匹配相关政策 。避免临近投稿才发现数据不符合资助方的“透明度要求”或“共享规定”,那将面临巨大的修改成本 。
法则 2:伦理与法律是“高压线”
对于我们研究人类被试的心理学和脑科学领域,这一条是底线。必须时刻遵守伦理原则(如赫尔辛基宣言)和法律法规(如GDPR)。在数据采集前,务必通过伦理委员会(IRB)审核。
特别注意数据的去标识化(De-identification),保护被试隐私,签署知情同意书。
法则3:构建“3-2-1”数据存储堡垒
硬盘损坏是每个研究者的噩梦。作者强烈推荐数据备份的 “3-2-1 原则” :
3 份副本: 保留原件加上两份备份。
2 种介质: 存放在两种不同的存储设备上(例如:本地电脑 + 机构网络云盘/移动硬盘)。
1 个异地备份: 至少有一份备份不在你现在的办公地点(防止火灾、盗窃等物理灾害)。
对于敏感数据,务必使用加密工具(如 Veracrypt)进行保护 。
法则4:拒绝混乱,让文件夹结构化
良好的文件夹架构和明明习惯会使得科研事半功倍,但这往往是很多人的痛点。作者在文中提供了两个非常实用的图表方案:
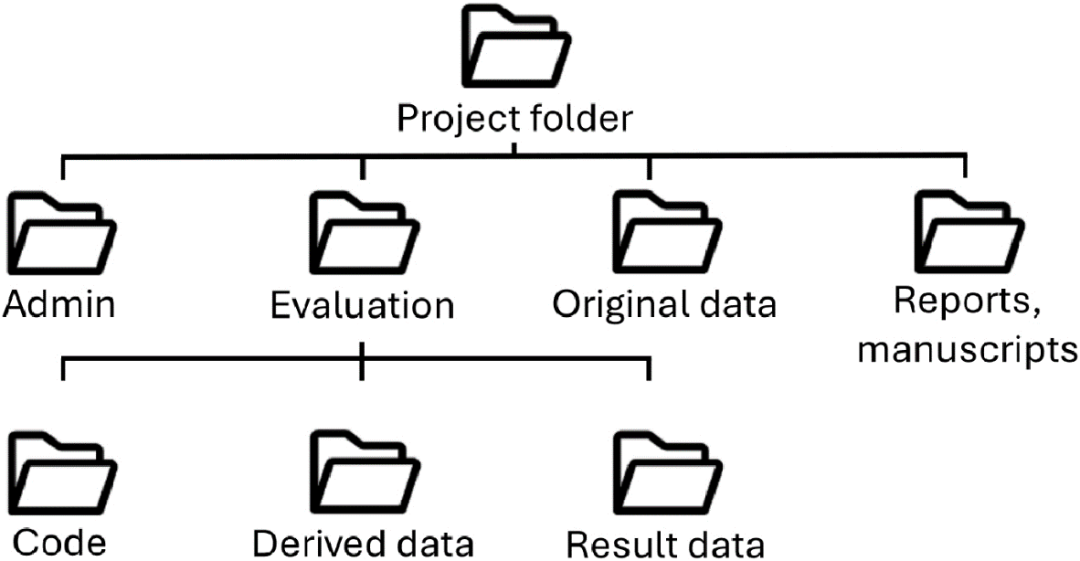
Fig 2. Exemplary folder structure.
针对文件夹结构,不要把所有文件都堆在根目录下。建立一个逻辑清晰的树状结构 :
一级目录: 项目文件夹。
二级目录: 管理(Admin)、评估(Evaluation)、原始数据(Original data)、报告/手稿(Reports, manuscripts)。
三级目录(示例): 在“评估”文件夹下,再细分为代码(Code)、衍生数据(Derived data)、结果数据(Result data)。
(注:如 Fig2 所示,统一的结构能让你和合作者迅速定位文件 )
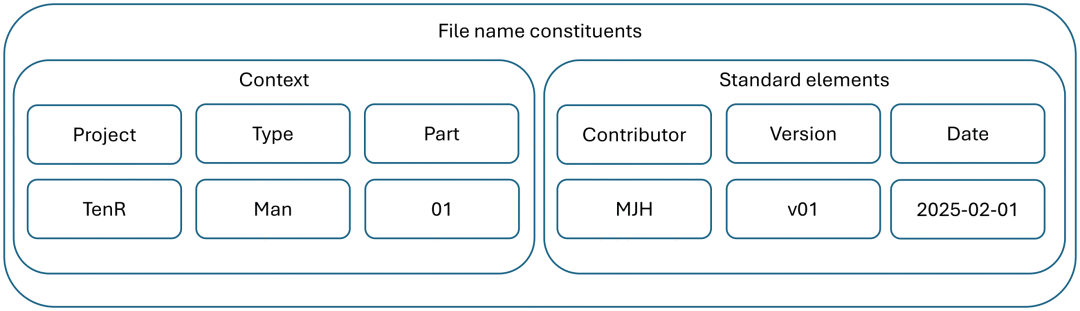
Fig 3. Exemplary file naming structure.
针对文件命名规范,文件名应包含“上下文”和“标准元素”
上下文: 项目名(Project)+ 类型(Type)+ 部分(Part)。
标准元素: 贡献者(Contributor)+ 版本(Version)+ 日期(Date)。
示例: TenR_Man_01_MJH_v01_2025-02-01.docx
(注:Fig3 示例的命名方式能让你一眼看出文件内容,无需打开文件 )
法则5:采集数据,贵在“精准”与“克制”
数据不是越多越好,冗余的数据会带来巨大的管理成本 。
预先规划: 在动手前,明确你需要什么数据来回答科学问题 。
样本量计算: 依据统计学效力(Power analysis)确定最小样本量,不多采也不少采 。
试点研究(Pilot Study): 正式采集前跑一个小样本,确保流程顺畅,数据质量达标 。
法则6:文档是数据的“说明书”
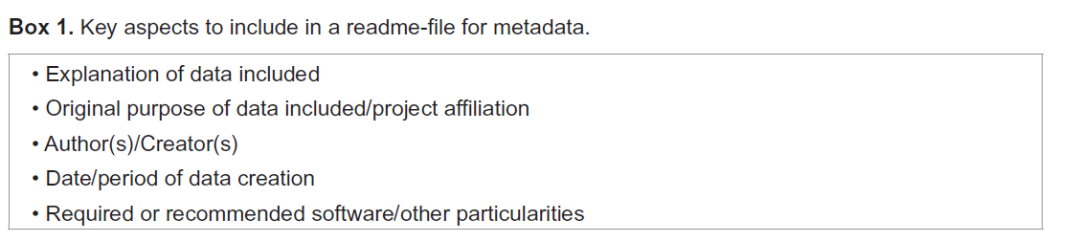
没有说明和释义的数据是毫无价值的。作者建议每一个数据文件夹中都应包含一个 Readme 文件(对应论文 Box 1),其中必须包含 :
数据的解释;
数据的原始目的/项目归属;
作者/创建者;
数据创建日期/时间段;
所需的软件或特殊说明。
对于更复杂的数据,还可以使用数据字典(Data Dictionaries)或标准化的元数据格式(如 Dublin Core)。
法则7:制定数据管理计划 (DMP)
DMP 应在项目启动时撰写,并伴随项目全周期 。作者列出了DMP必须回答的关键问题:
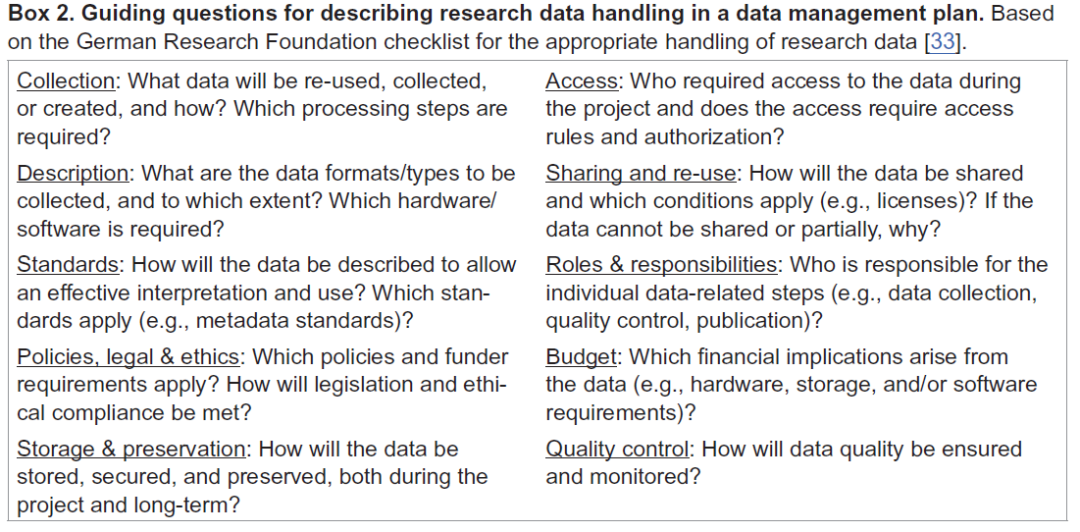
采集: 收集什么数据?怎么收集?
访问: 项目期间谁有权访问?
标准: 使用什么元数据标准?
共享: 怎么发布?有什么许可证(License)?
预算: 存储和管理需要多少钱?
长期保存: 项目结束后数据存在哪?
法则 8:使用“开放”和“标准”的文件格式
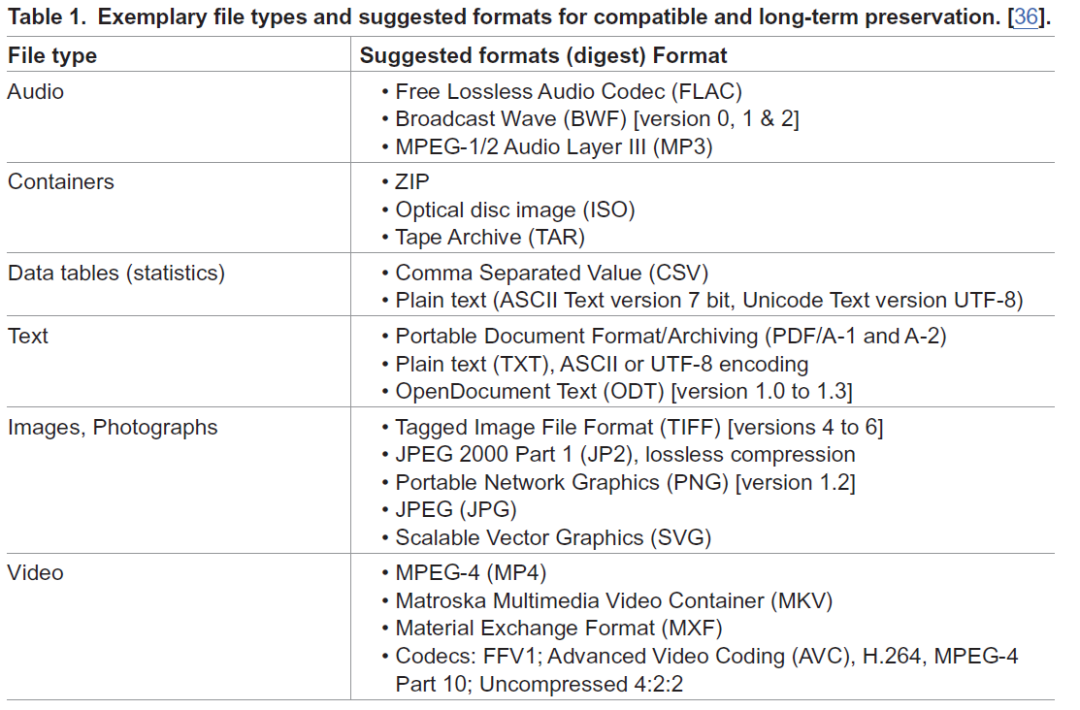
为了确保你的数据在10年后还能打开,尽量避免使用专有的、封闭的格式(Proprietary formats)。作者在 Table 1 中推荐了各领域的最佳格式 :
表格数据: 推荐 .csv(逗号分隔值),而不是 .xlsx。
文本: 推荐 .txt 或 .pdf/a,而不是 .doc。
图像: 推荐 .tiff 或 .png(无损),而不是有损压缩格式。
音频: 推荐 .flac 或 .wav。
法则 9:让数据创造价值:共享与发布
数据发布不仅仅是上传文件,而是一个流程。文中提供了一个清晰的发布流程图:
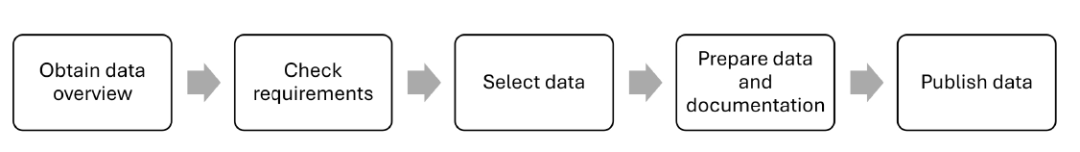
Fig 4. The process of data publication
获得数据概览 (Obtain data overview)
检查要求 (Check requirements): 资助方和期刊的要求。
选择数据 (Select data): 依据 Table 2 的标准,选择具有独特性、复用价值的数据发布;剔除测试数据或错误数据 。
准备数据与文档 (Prepare data and documentation): 确保去标识化(De-identification)处理 。
发布数据 (Publish data): 选择合适的存储库(如 Zenodo, Dryad),获取DOI 。
法则 10:持续的自我监测
RDM 不是一劳永逸的任务。
定期复盘: 定期检查你的进度、存储配额和文档完整性 。
技能提升: 在自我监测的过程中,你不仅是在管理数据,更是在评估和提升自己的科研管理能力 。
结语
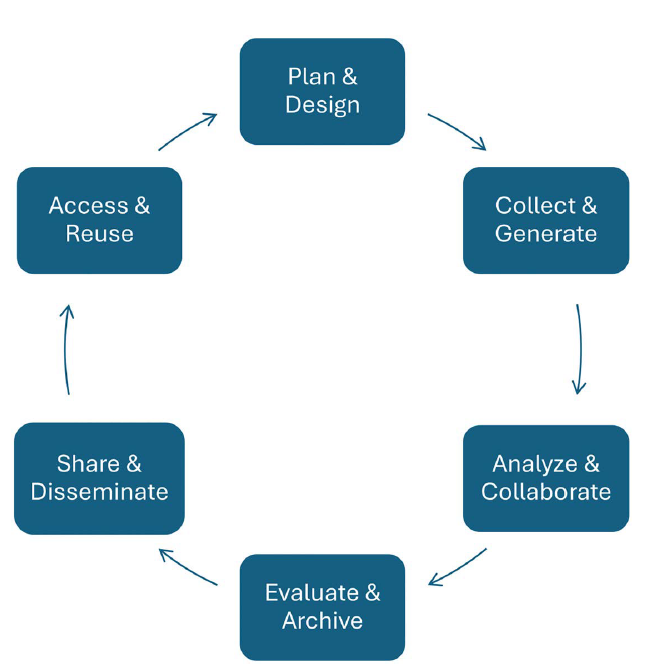
Fig 1. Data life cycle. Suggested by Surkis and Read [7], own illustration
从 Fig1 展示的数据生命周期(Data Life Cycle)来看,数据管理贯穿了从“计划与设计”到“评估与归档”的每一步 。希望这份基于 PLoS Computational Biology 新文的详细解读,能帮助大家建立起更规范的科研习惯。毕竟,不被混乱的数据绊倒,我们才能在探索大脑奥秘的路上跑得更快。
基本信息:
Title: Ten simple rules for effective research data management
发表时间:2025.12.8
Journal:PLOS Computational Biology
影响因子:3.6 Q1
获取原文:
- *添加小助手:*PSY-Brain-Frontier即可获取PDF版本
- 点击页面底部“阅读原文”即可跳转论文原网页
前沿交流 | 欢迎加入认知神经科学前沿交流群!
⭐️[解读链接]
核心图表、方法细节、统计结果与讨论见原文及其拓展数据。
分享人:天天
审核:PsyBrain 脑心前沿编辑部
预览时标签不可点
阅读原文
不喜欢
微信扫一扫
关注该公众号
知道了
微信扫一扫
使用小程序
取消 允许
取消 允许
取消 允许
× 分析
微信扫一扫可打开此内容,
使用完整服务