D043 德累斯顿工业大学、蒙彼利埃大学等 bioRxiv 四篇预印本精选 | 认知努力、巴甫洛夫干扰、前向规划与学习率
来源:公众号 PSY-Brain_Frontier | 发布:2026-10-16 | 原文链接
● 认知神经科学前沿文献分享
本期介绍四篇 bioRxiv 预印本,均未经同行评议。前两篇用到脑成像:一篇用 PET-fMRI 看尾状核的多巴胺 D2 受体,和人们愿不愿意付出认知努力有什么关系;一篇比较有无酒精使用障碍的人,面对与目标冲突的线索时,行为和前额叶激活有什么不同。后两篇关注学习与决策的计算:一篇用模型看人在序列决策里,什么时候靠任务偏好、什么时候多算几步;一篇让小鼠在不同的环境里选杠杆,看它们怎样调整学习率。
做不做费脑子的事,尾状核D2受体可用性与选择有关
● 关键词:认知努力|多巴胺D2受体|尾状核|PET-fMRI|生态瞬时评估
Caudate dopamine predicts cognitive effort decisions both in the lab and daily life
DOI:https://doi.org/10.64898/2026.09.26.754663
作者:Jennifer L. Crawford、Rachel E. Brough、Sarah A. Eisenstein、Jonathan E. Peelle、Todd S. Braver
通讯作者及单位:Jennifer L. Crawford — Department of Psychological and Brain Sciences, Washington University;Department of Psychology, Brandeis University;Center for Vital Longevity, University of Texas at Dallas
每个人每天都要决定,要不要去做费脑子的事。Crawford 等人想知道,尾状核的多巴胺 D2 受体,和这种个体差异有没有关系。
研究对象是21名18—40岁的健康成人。参与者完成认知努力折扣范式(Cognitive Effort Discounting,Cog-ED),在报酬较高的高负荷(2–4-back)和报酬较低的 1-back 之间选择,同时用正电子发射断层成像—功能磁共振成像(PET-fMRI)测量纹状体 D2 受体可用性和决策时的脑活动。他们还做了 N-Back 任务,并连续7天用生态瞬时评估(Ecological Momentary Assessment,EMA)记录日常活动的心理负荷。
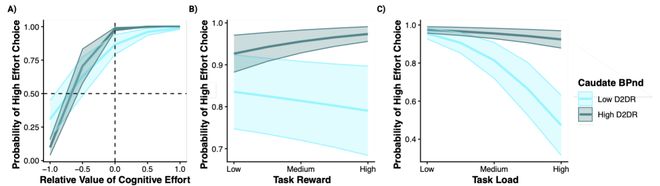
工作记忆负荷越高,准确率越低,参与者也越少选高努力选项。尾状核 D2 受体较高的人,准确率随负荷增加下降得更缓;未控制年龄时更常选高努力选项,控制年龄后不再显著(p=0.062)。做决策时,他们对成本—收益权衡的变化更敏感:D2 受体调节相对主观价值与选择的关系(OR=5.78,p<0.001),金钱回报增加时他们更愿意选高努力,负荷升高时选高努力的比例也下降得更少。D2 受体与基线努力成本没有显著关联。
尾状核 D2 受体可用性也与努力价值变化时腹内侧前额叶、腹侧纹状体的活动调节相关,腹侧纹状体自己的 D2 可用性没有同样的模式。研究预注册时原本预计腹侧纹状体更敏感,结果主要指向尾状核。EMA 里,尾状核 D2 较高的人报告参与了更多费脑子的活动(B=0.58,p=0.008)。作者认为,尾状核 D2 受体可能是个体认知努力动机差异的一条神经化学线索。这是21名健康成人的相关数据,样本较小,不能据此判断 D2 受体可用性会直接导致选择的变化。
巴甫洛夫线索会压过目标行为吗?酒精使用障碍中的PIT干扰
● 关键词:巴甫洛夫—工具性转移|PIT干扰|酒精使用障碍|吸烟|前额叶控制
Reduced Control Over Pavlovian-to-Instrumental Transfer in Human Addiction: A Systematic Investigation Across Alcohol Use Disorder and Smoking Status
DOI:https://doi.org/10.64898/2026.09.25.754324
作者:Louis Thill、Hao Chen、Christian Bäuchl、Samanda Krasniqi、Maren Born、Michael Marxen、Eva Friedel、Maximilian Pilhatsch、Andreas Heinz、Michael N. Smolka
通讯作者及单位:Michael N. Smolka — Section of Systems Neuroscience, Department of Psychiatry and Psychotherapy, Technische Universität Dresden
很多人知道自己想少喝酒,但环境里的线索一出现,行动还是可能被它带偏。巴甫洛夫—工具性转移(Pavlovian-to-Instrumental Transfer,PIT)描述的就是这种影响:先前学到的线索会改变正在进行的目标导向动作;线索推动的反应与当前任务要求冲突时,就形成 PIT 干扰。
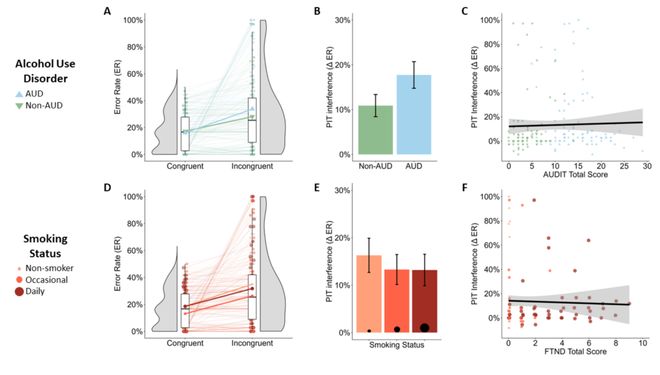
Thill 等人从德国普通人群纳入200名参与者,100人符合酒精使用障碍(Alcohol Use Disorder,AUD)标准,100人没有;样本中的吸烟状态也分成不吸烟、偶尔吸烟和每天吸烟三组。参与者先学会拉杆收集“好”贝壳、推杆拒绝“坏”贝壳,再学习视听线索与金钱、酒精、吸烟或中性结果的关联。功能磁共振成像(functional magnetic resonance imaging,fMRI)扫描中,线索提前600毫秒出现,随后呈现贝壳;线索推动的方向与正确动作一致或冲突,这里的一致和冲突只用金钱线索(赢10、输10)的试次来划分;PIT 干扰就用两类试次的错误率之差来计算。
有 AUD 的人 PIT 干扰更强,错误率之差为17.74%,没有 AUD 的人为10.90%。PIT 干扰还与 AUD 严重程度、饮酒频率、饮酒量和酒精渴求正相关,但没有预测随访期间的饮酒轨迹。吸烟状态、尼古丁使用严重程度、吸烟频率、数量和渴求,都没有显示出同样的关系。
脑成像显示,两组的差异出现在冲突处理相关的前额叶和前扣带皮层:遇到不一致的线索时,AUD 组右侧外侧前额叶、双侧背内侧前额叶和前扣带皮层的激活,低于无 AUD 组。作者据此把 AUD 中增强的 PIT 干扰,与冲突时前额叶控制网络的招募较少联系起来,并把这项研究看作对既有高风险饮酒者和酒精依赖患者结果的扩展。PIT 只在一次任务中测量,多数分析是横断面关联,还不能判断 PIT 干扰与饮酒之间的因果方向。
先凭偏好,还是先算未来?任务结构怎样引导连续决策
● 关键词:任务特异偏好|前向规划|序列决策|计算模型|反应时
Task-specific preferences guide forward planning in sequential decision-making
DOI:https://doi.org/10.64898/2026.09.25.754065
作者:Alex Lepauvre、Florian Ott、Stefan Kiebel
做决定时,我们不可能把每个选项的长期后果都算到底。在复杂的序列决策任务里,人会不会先凭对这个任务的偏好,得到一个快速的方向,只在这个方向不清楚的时候,才多算几步?Lepauvre 等人对 Ott 等人此前发表的一组数据重新做了分析,检验的就是这个想法。
40名参与者在240个测试试次里,决定接受还是拒绝1—4分的报价。接受会得到报价,但要付出1或2点能量;拒绝没有即时奖励,却能补回1点能量。成本连续4个试次不变,参与者也知道下一段的成本,当前选择还会改变下一步的状态。研究者先用最优的前向规划(forward planning)算出每个状态下接受和拒绝的长期价值,再比较四类选择模型,其中主模型把报价、能量、当前成本和未来成本的任务特异偏好,与规划价值结合起来。
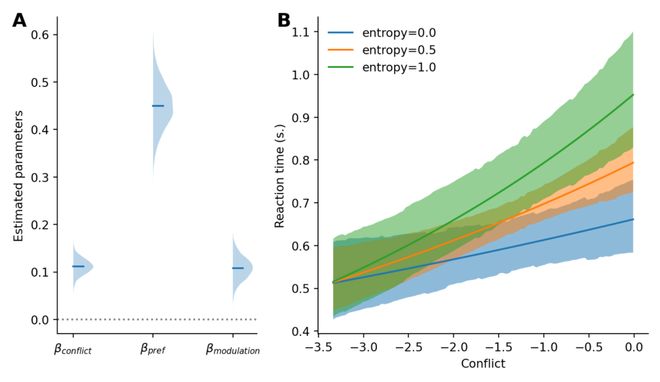
主模型在34名参与者身上拟合得最好,优于只用规划、近期行动频率或报价情境的模型。这些偏好不是固定的倾向:低报价比最优规划预测的更常被拒绝,高报价更常被接受,能量状态也会改变选择。偏好给出的行动方向越不确定,规划价值对选择的影响越强,反应时(reaction time,RT)上也看到了同样的依赖。只用拟合出的偏好生成策略,收益比最优规划低28.34%,但仍优于随机选择,所以作者认为这些偏好保留了任务里与收益有关的结构,却不能完全替代前向规划。
作者把结果解释为一种受贝叶斯(Bayesian)思想启发的组合:偏好像是随时可用的先验,前向规划在偏好给不出清楚方向时补充计算。
小鼠区分波动性与随机性调整学习率
● 关键词:学习率|波动性|随机性|强化学习|概率反转任务
Mice adapt their learning rate to stochasticity and volatility through a simple heuristic
DOI:https://doi.org/10.64898/2026.09.24.754025
作者:Coline Chevallier、Juan Cobos、Emma Debos、Emma Marillat、Julie Perroy、Jérémie Naudé
通讯作者及单位:Jérémie Naudé — IGF, Univ. Montpellier, CNRS, Inserm
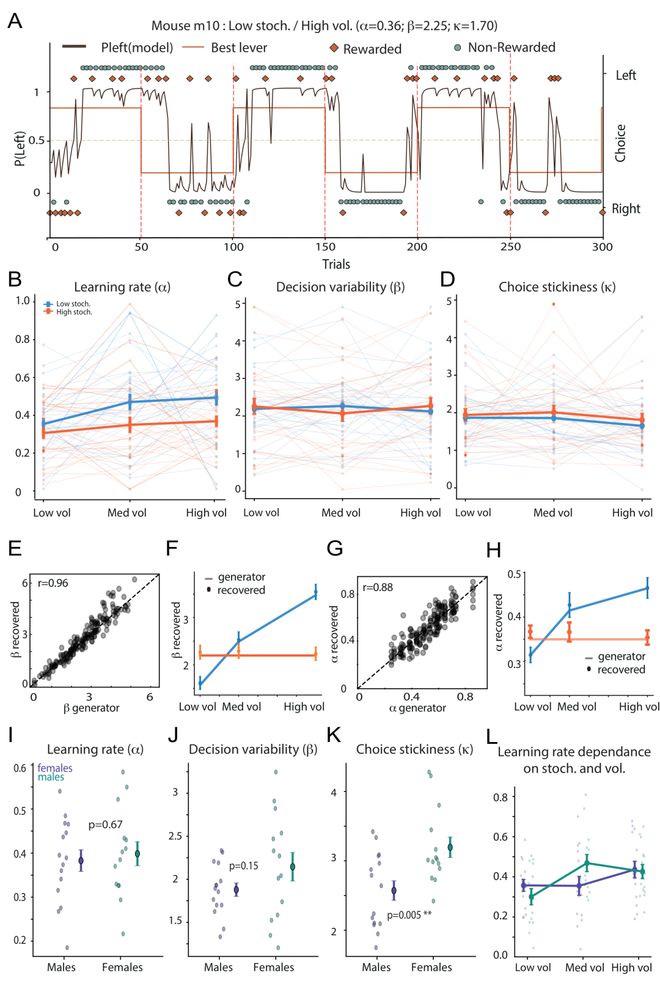
同一个没得到奖励的结果,可能只是稳定规则下的噪声,也可能提示奖励规则已经变了。波动性(volatility)指规则改变的速率,随机性(stochasticity)指规则不变时结果的噪声。Chevallier 等人想知道,小鼠能不能把两者分开,并相应地调整学习率(learning rate)。
团队分析了29只小鼠在概率反转任务(probabilistic reversal task)里的表现。奖励概率是80/20或64/16,奖励脉冲数相应调为1倍或1.25倍,使两个选项的期望奖励和差值保持不变;波动性用每25、50或100次按压后反转来表示。小鼠得到的是内侧前脑束(medial forebrain bundle,MFB)的颅内自我刺激(intracranial self-stimulation,ICSS)作为奖励,六种环境共记录144,647次试次。
成功率随随机性和波动性的增加而下降。没得到奖励后换杠杆的概率,随波动性升高、随随机性降低,得到奖励后基本不变。强化学习(reinforcement learning,RL)模型拟合显示,学习率随波动性升高、随随机性降低,逆温度(inverse temperature)在六种环境间基本稳定。模型模拟还发现,只有一种元强化学习(meta-RL)规则同时复现了这两个方向:它根据近期结果有多常提示该换杠杆来估计波动性,用预测误差的大小来估计随机性;只凭预测误差大小估计波动性的规则没有做到。
作者认为,这项设计把结果噪声和规则变化率拆开,为在动物身上研究学习率怎样适应两类不确定性,提供了可检验的任务和模型。