D046 bioRxiv 方法学解读|训练匹配审计:怎样把“认出熟悉刺激”和“迁移到新刺激”分开
来源:公众号 PSY-Brain_Frontier | 发布:2026-10-22 | 原文链接
● 认知神经科学前沿文献分享
论文信息:Stimulus overlap confounds generalization in EEG foundation-model benchmarks
发表期刊:bioRxiv
01 训练和测试看的是同一批片子,跨被试成绩里混进了什么
脑电(EEG)情绪解码的常规评估是跨被试:训练集和测试集用不同的人,看模型能不能迁移到新个体。常用的公开数据集有个共同结构:很多参与者看同一小批电影片段或音乐视频,每段片子对应一个固定的类别标签。留出被试以后,训练和测试确实是不同的人,但他们看的是同一批片子。
这样一来,片子是哪一段,本身就能预测标签。模型只要学会认出“这是哪一段熟悉的片子”,不用学到任何能带到新材料上的规则,也能在跨被试评估里拿到高分。机器学习里把这类现象叫捷径(shortcut)。跨个体泛化和向新刺激泛化本来是两种预测能力,留出被试的基准却只给一个分数。
EEG 基础模型(在大规模 EEG 语料上预训练、用来学习可复用神经表征的模型)的评估沿用了这套范式。预训练模型比手工特征高出来的那部分成绩,是迁移得更好,还是更会认熟悉片段,现有基准分不开。作者提到,此前已有工作提示刺激重复可能影响评估,但那些研究里的已见和未见条件,常常在测试试次、训练刺激集或训练数据量上本身就不一样,很难单独看出“熟悉”起了多大作用。
这篇论文提出的办法叫训练匹配审计(training-matched audit)。它是一篇 bioRxiv 预印本,未经同行评议。
02 这批数据为什么能拆开,怎么拆
先看数据。论文用了七个公开的 EEG 情绪数据集(FACED、SEED、SEED-IV、SEED-V、SEED-VII、DEAP、DREAMER),合成十项任务,覆盖 15—123 名参与者和 15—80 段片子。六个数据集让参与者看电影片段,DEAP 放的是一分钟的音乐视频。这批数据能做拆分,靠三个条件。第一,每个试次都能对应到具体的片段,所以能按片段划分数据。第二,片段和参与者都够多,可以按折划分,造出“训练里含测试片段”和“训练里不含测试片段”两种训练集,同时让训练参与者数和每类片段数保持一致。第三,标签由片段的指定类别决定,片段和标签绑在一起,捷径才有可能存在。
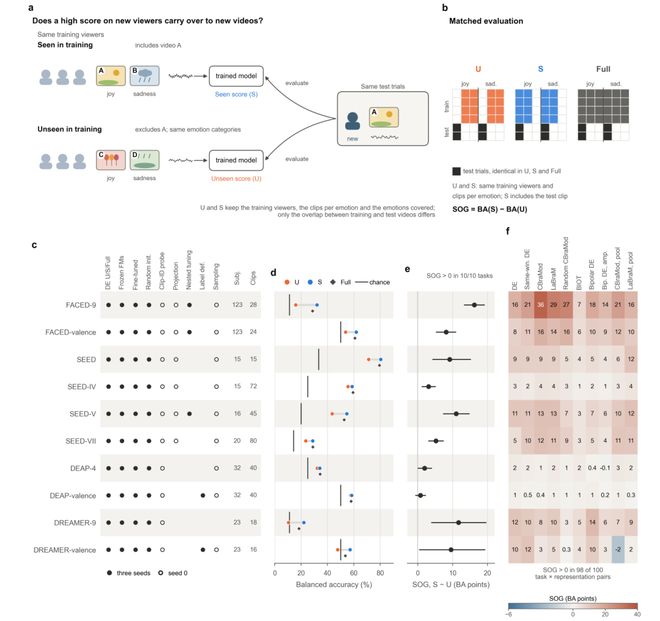
具体的划分是这样的。参与者按五折划分,每次用某一折的参与者去看某一折的片段,训练和测试的参与者互不重叠。在同一批测试试次上,比较三种训练配置。未见臂 U 用其余参与者、且不含测试片段的试次训练,每个测试片段对模型都是新的。已见臂 S 同样用其余参与者训练,训练参与者数和每类片段数与 U 严格相同,区别只在于训练的片子里包含测试片段,这些试次来自其他参与者。Full 臂用全部片段训练,相当于已发表基准的做法。S 与 U 的平衡准确率之差,论文定义为刺激重叠增益(stimulus-overlap gain,SOG)。测试试次、训练参与者数和每类片段数都固定了,这个差就大致等于“训练时见过这段片子”带来的好处。
比较的表征分两类。经典的一类是差分熵(differential entropy,DE)特征加线性读出。另一类是三个官方预训练的基础模型 CBraMod、LaBraM 和 BIOT,它们先冻结参数做线性读出,再用 LP-FT(先训练线性头、再微调整个网络)微调。要判断预训练本身有没有用,作者还给 CBraMod 和 LaBraM 各配了架构完全相同、随机初始化的网络,读出和微调方案不变。
为了解释结果,论文做了两个分析。刺激可辨识性用线性探针衡量:在同一情绪类别内,判断新参与者看的是哪一个具体视频,0 分是随机水平,100 分是完全识别。子空间移除则是估计出片段相关的方向,从所有窗口里投影掉,再看 SOG 变不变,并用秩匹配的随机方向做对照。统计上,置信区间默认用交叉自助法,同时对参与者和类别内的片段做有放回重采样;主要检验是 DE 在十项任务上 SOG 是否大于零,用单侧自助检验,经 Holm 校正。
03 拆开以后,多看到了什么
先看常规基准。用 DE 加线性读出,十项任务里熟悉片段的准确率都高于新片段。SOG 从 DEAP-valence 的 0.8 个平衡准确率点,到 FACED-9 的 16.2 点。FACED-9 上,已见片段高出机会水平的那部分准确率,有 77.4% 来自刺激重叠。常规 Full 基准的准确率,在每项任务里都与已见片段的准确率相差不到 3.7 点,更接近已见片段而不是新片段。所以只看 Full 基准,会读到一个看起来不错的准确率,像是模型学到了情绪;拆开以后才看到,这个分数大部分是熟悉片子上的分数。这个现象也不限于某一种表征:十种冻结表征共 100 个任务×表征组合里,SOG 在 98 个里为正。摘要说刺激重叠让 DE 解码准确率在每项任务里都提高,指的是方向在十项任务里一致,单侧检验经 Holm 校正后显著的有七项。
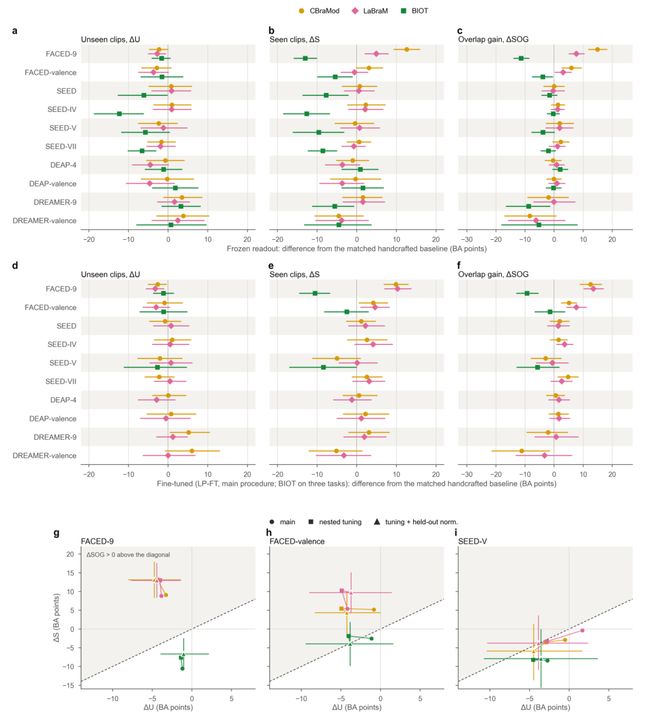
再看基础模型。作者想知道,基础模型比手工特征强的那部分,在新片段上还在不在。办法是分别算每个模型减去其匹配基线的差,在新片段上记为 ΔU,在已见片段上记为 ΔS,两者之差(交互项,ΔSOG)为正,说明优势在熟悉材料上被放大。FACED-9 上,冻结的 CBraMod 在熟悉片段上比同窗口 DE 高 12.6 点,在新片段上没有可检测的优势,差值是 −2.3 点,交互项为 14.9 点。放大到全部 53 个冻结和微调比较,只有 DREAMER-9 上微调后的 CBraMod 在新片段上明确优于匹配基线,其余多数设置里,CBraMod 和 LaBraM 的增益都集中在熟悉刺激上。换成 LP-FT 或嵌套调参(模型和基线各自在验证参与者与片段上独立调参),FACED-9 的交互项仍在 12.5 点以上。BIOT 的模式相反:十项任务中有八项,它在熟悉片段上的准确率低于双极导联 DE。
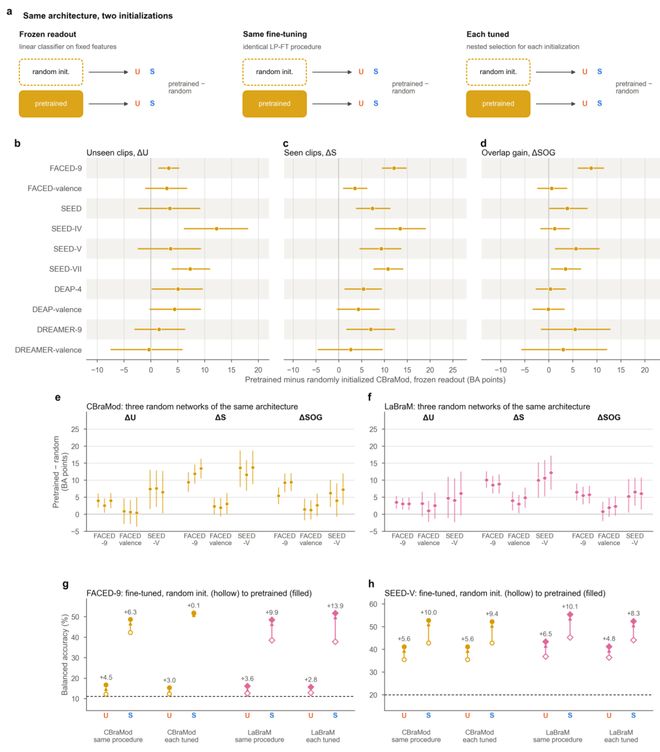
那预训练到底有没有用?随机初始化对照给出的答案是:有,但比 Full 基准让人以为的小。冻结线性评估中,预训练的 CBraMod 在十项任务里的九项于新刺激上优于随机初始化的同架构网络,同样是这九项,它在熟悉刺激上的增益更大。FACED-9 上相同的 LP-FT 方案下,预训练使新片段的准确率提高了 CBraMod 4.5 点、LaBraM 3.6 点,而熟悉片段分别提高 6.3 点和 9.9 点。嵌套调参后,新片段上仍有 2.5—3.0 点的预训练优势,四个区间都在零之上。熟悉片段上的情况因架构而异:CBraMod 单独调参后,随机初始化版本在熟悉片段上的准确率(51.7%)和预训练版本(51.9%)几乎一样,在新片段上却低一些(12.3% 对 15.4%)。这说明监督训练就能追回 CBraMod 大部分熟悉片段上的表现,预训练多给的是新刺激上较小但一致的收益。LaBraM 则不同,预训练在熟悉片段上仍保留 13.9 点的优势。只看 Full 基准的分数,这几部分贡献是分不开的。
至于原因,作者的解释是模型在利用刺激身份。全部 100 个任务×表征组合中,刺激可辨识性与 SOG 相关,Spearman ρ=0.87,去掉任务均值后为 0.86,排除 FACED 后为 0.83。FACED-9 上,CBraMod 和 LaBraM 的片段识别得分(70.8 和 64.5)高于同窗口 DE(48.5),BIOT(22.1)则低于双极 DE(49.3),方向与它们放大或压低 SOG 一致。这些相关都只是描述性的,因为同一任务内的组合共享数据。更接近干预的证据来自子空间移除:相对随机方向,移除片段方向使 FACED-9 上的 SOG 降低 4.1 到 4.7 点,新刺激的准确率变化不大;熟悉刺激的解码在三个基准的 12 个比较中全部下降。再把 DE 能预测的那部分模型成分线性移除,FACED-9 上基础模型相对 DE 的超额 SOG 减少,LaBraM 减少 82%,CBraMod 减少 35%。作者据此提出,基础模型大量用到了传感器特征本来就能解码的、与刺激锁定的低层频谱结构。
另有两条次要发现。标签怎么定义会改变膨胀的大小:DREAMER 有指定效价的 16 段片段上,把指定标签换成个人自评,DE 的 SOG 从 9.5 降到 −0.4。刺激怎么取样也有差别:参与者×刺激的记录总量固定时,把每类片段数加倍,比把参与者数加倍更能提高新刺激的准确率,FACED-9 和 SEED-V 上分别是 1.9 对 0.5 点、4.9 对 2.9 点。
读这些结果,有几处要小心。它是未经同行评议的预印本。证据全部来自电影和音乐视频基准,观察者共享丰富的动态感觉流,静态视觉刺激、自发情感和静息态评估没有检验。三个基础模型的架构、预训练语料和目标各不相同,用的又是官方权重,所以模型之间的差异(比如 BIOT 和另外两个)不能归因于单一因素。每类片段只有两到二十个,置信区间只反映参与者和片段的抽样不确定性,作者建议把成对差值和交互项当作跨任务的模式来读,不当作逐任务的结论。
04 我的数据也能这样分析吗
如果你的数据是多名参与者看同一批刺激、标签由刺激类别决定,结构上就和这里一样,可以试试这个思路。EEG、MEG、fMRI 的情绪或类别解码,视觉和听觉的刺激分类,都可能是这样的数据。论文本身只在 EEG 情绪数据上检验过。前提是每个试次都能对应到具体的刺激,这样才能造出训练里含、不含测试刺激的两种训练集。
迁移时最需要核对三件事。第一,匹配要做足:U 和 S 的训练参与者数、每类刺激数、训练窗口数都要对齐,并在同一批测试试次上打分,否则“已见”多出来的优势可能只是数据更多。第二,想知道预训练有没有用,除了手工特征,还要加一个同架构、随机初始化的网络,用相同的读出和微调方案。第三,参与者和刺激要同时重采样。论文里每类片段只有两到二十个,只对参与者重采样,置信区间会虚假地偏窄。
作者给十项指定标签任务做了一个基于 CPU 的评估包,固定了参与者与片段的划分,不需要 EEG 数据或模型权重。不过数据和代码要等论文发表后才放到 Zenodo。作者还建议,基准应同时报告熟悉刺激和新刺激上的表现,并对照输入匹配的基线,把刺激多样性当作与被试规模并列的扩展维度。