P033 TiCS综述 | 灵长类大脑如何处理声音信息
来源:公众号 PSY-Brain_Frontier | 发布:2026-04-16 | 原文链接
认知神经科学前沿文献分享

基本信息
Title: Voice information processing by the primate brain
发表时间: 2026-02
发表期刊:Trends in Cognitive Sciences
获取原文:
-
添加小助手: PSY-Brain-Frontier 即可获取PDF版本
-
点击页面底部“阅读原文”跳转论文网页


引言
我们日常听到的声音,远不只是语言内容的载体。很多时候,在一句话尚未说完之前,大脑已经开始判断“是谁在说话”“此刻情绪如何”“这是不是熟悉的人”,甚至进一步推测说话者的意图与社会意义。正因如此,作者把声音称作听觉中的“面孔”,强调它和视觉中的面孔一样,都是高度浓缩、动态变化、却又极具社会信息密度的线索。
不过,相比语言和语音研究,神经科学对“声音本身如何被知觉和表征”的关注长期并不充分。过去相关证据分散在不同方法之中:功能磁共振成像(fMRI)揭示了声音选择性皮层区域,脑电和脑磁图追踪了声音加工的时间进程,猕猴和狨猴研究则把问题推进到进化层面。但这些发现往往彼此独立,导致领域内虽然已知道大脑会优先处理声音,却仍缺少一幅跨物种、跨尺度、跨方法的整合图景。尤其关键的问题仍待回答:这种声音选择性网络是否为灵长类共享特征;它到底多快开始把声音与非声音区分开来;身份、熟悉性和情绪等更高阶信息又是怎样逐步建立的。
这篇综述的重要性,就在于把原本零散的证据重新组织起来。作者综合人类与非人灵长类的 fMRI、颅内记录、单神经元研究以及近年的计算模型,试图说明声音加工并不是一组松散现象,而是一个具有相对稳定组织原则的系统。文章尤其强调三点:其一,灵长类可能共享一套进化保守的“声音斑块”系统;其二,声音与非声音的神经区分出现得比早期认识更快,而且更高阶社会信息会沿时间和层级逐步展开;其三,深度神经网络和潜在空间模型正在为理解“大脑如何把复杂声学输入转成稳定身份表征”提供新的计算语言。
实验设计与方法逻辑
文章按照“网络定位—跨物种比较—时间动态—行为相关表征—计算模型”的逻辑整合既有研究。文章先梳理人类颞叶声音区(temporal voice areas, TVAs)及额叶声音区(frontal voice areas, FVAs),明确声音加工的核心与扩展网络;随后结合猕猴、狨猴的 fMRI 和单神经元记录,讨论声音斑块是否具有功能同源性。接着,作者汇总 EEG、MEG、立体脑电(sEEG)、皮层脑电(ECoG)和猕猴电生理,重建声音加工的快速时间展开。
核心发现
发现一:灵长类存在可跨物种对照的声音选择性区块系统
这篇综述首先把一个关键事实讲清楚:声音选择性脑区并非人类独有。根据人类、猕猴和狨猴的 fMRI 证据,作者总结出灵长类次级听觉皮层内存在功能上可比较的“声音区块”系统。人类中,最稳定的核心网络是沿上颞回/上颞沟(STG/STS)分布的后部、中部和前部颞叶声音区;猕猴和狨猴也可见前部或分布式声音区块。Figure 1 上半部分之所以重要,就在于它把三类灵长类的相关脑区直接放在同一进化框架下展示,视觉上支撑了“功能同源”的主线。

Figure 1. From voice-selectivity maps to neurons
发现二:声音与非声音的区分出现很早,并在时间上逐步展开到更高阶社会信息
文章对时间维度的整合,是另一条非常重要的主线。早期 EEG 曾把声音/非声音区分放在约 320 ms,但后续高密度 EEG 和 MEG 发现,额颞部与声音相关的正成分可在约 170 ms 出现,已接近视觉中面孔 N170 的时间尺度。更关键的是,Figure 1 下半部分把人类颅内高伽马活动与猕猴单神经元记录并置,显示声音类别信息可在更早的 30–150 ms 内被神经系统提取,人类部分电极甚至早于 50 ms。
发现三:声音网络会编码身份、熟悉性与情绪,且这些表征会被经验进一步塑形
在“是不是声音”之外,这套网络真正服务的是社会交流中的有用信息。Figure 2A 汇总的人类 fMRI 结果显示,说话者身份不仅能从双侧 TVA 的活动模式中解码,也涉及顶叶和左额下回等区域,说明身份信息并不局限于单一听觉斑块。Figure 2B 进一步显示,熟悉声音在神经表征空间中的区分度更高:个人熟悉的声音会招募更广泛的人物身份网络,包括颞极、缘上回、前岛叶和内侧额叶,并表现出更强的表征差异。

Figure 2. Behaviourally relevant coding of voice identity across scales
发现四:计算模型提示声音身份表征可能依赖低维潜在空间与“流形解缠结”
这篇综述的理论整合,集中体现在对计算模型的讨论。作者指出,中部颞叶声音区(mTVA)的活动还可以较好地由基频、共振峰分散、谐噪比等声学维度解释,但到了前部 TVA,仅靠这些低层特征已不足以解释其表征性质,更需要引入对身份更稳定的抽象模型。Figure 3A 展示了自编码器、监督分类器和自监督模型如何把高维声音输入压缩为低维表示,这也是“声音潜在空间(voice latent space, VLS)”概念的核心意义。
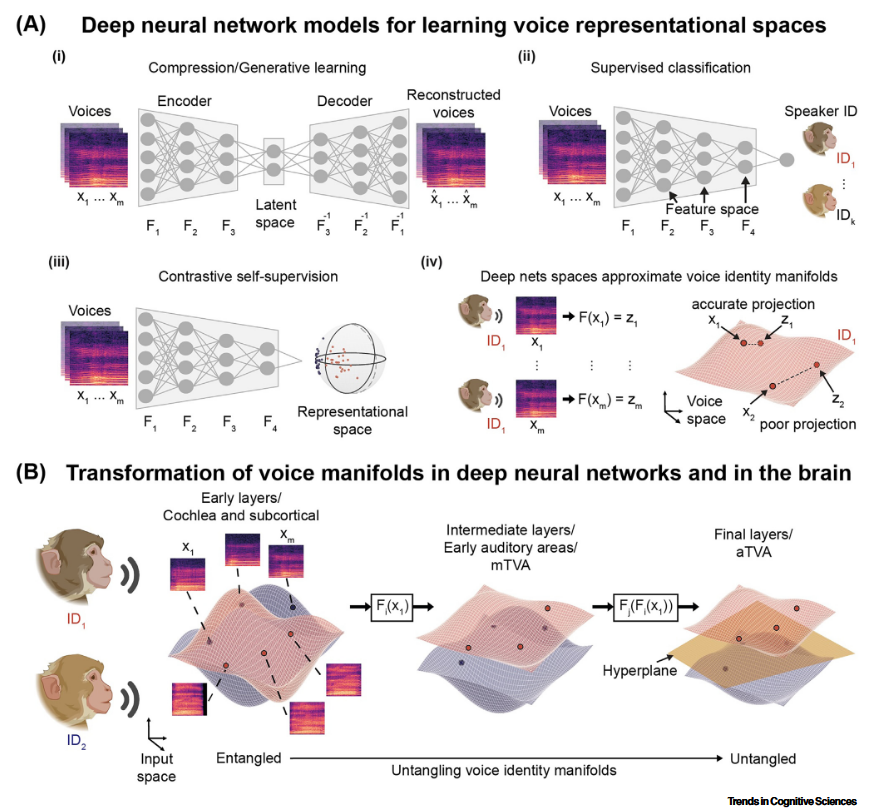
Figure 3. Modelling voice representations
归纳总结和点评
这篇综述最突出的贡献,是把声音选择性脑区、跨物种证据、快速时间动态、身份与情绪编码以及深度神经网络建模,整合成了一条相对统一的研究叙事:灵长类大脑中存在进化上延续的声音加工系统,它能够在极短时间内提取声音这一社会信号,并沿听觉层级逐步形成更抽象、更稳定、也更接近行为需求的身份与情感表征。文章尤其有价值的地方,在于把“声音是听觉中的面孔”从一个形象比喻推进为可比较、可建模、可跨物种检验的科学框架。不过它也清楚保留了边界:现有证据虽支持声音斑块的跨物种连续性与层级化表征,但关于这些斑块究竟是离散模块还是连续梯度、关键区域在知觉中的必要因果作用为何、以及深度模型与真实神经实现之间能对应到什么程度,仍是需要后续实验回答的开放问题。
分享人:BQ
审核:PsyBrain 脑心前沿编辑部
💡 关于我们
👋 你好,这里是「PsyBrain 脑心前沿」
🧠 专注追踪全球认知神经科学的最尖端突破
🔍 视野直击 Nature, Science, Cell 正刊 及核心子刊与顶级大刊
📄 每日速递「深度解读」与「前沿快讯」
科研是一场探索未知的长跑,但你无需独行。欢迎加入 PsyBrain 学术社群,和一群懂你的同行,共同丈量脑与心智的无垠前沿。
👇点击卡片进群,欢迎你的到来👇

一键关注,点亮星标 ⭐ 前沿不走丢!

一键分享,让更多人了解前沿
作者提醒:内容由AI生成
预览时标签不可点
阅读原文
不喜欢
微信扫一扫
关注该公众号
知道了
微信扫一扫
使用小程序
取消 允许
取消 允许
取消 允许
× 分析

微信扫一扫可打开此内容,
使用完整服务